用 Claude Code 或 Codex 久了,很多人都会走到这一步:一个窗口在修 bug,一个在写新功能,一个在跑测试,还有一个在回答你半小时前问的问题。每个窗口里的 Agent 交代清楚后都能自己跑很久,可是窗口一多,人就得在它们之间来回切换,记着哪个已经跑完、哪个刚才说到哪里、哪个停在那里等人确认。
DeepSeek Harness 团队 10 月 31 日发布了一篇架构文章(全文转载在这里),开头描述的就是这个处境。按他们的观察,一个人通常只能同时跟进 3 到 5 个活跃会话,因为现在的 Agent 仍以单个会话为基本单位,会话之间互不相通,用户并行推进几件事时,得自己手动切换、自己记住每个会话的上下文。文章的说法是,在这种设计下,单任务的上限取决于模型能力,多任务的上限取决于人的注意力。他们也提到,只在本地单会话 Agent 上接 CLI、MCP 或外部连接器,Agent 虽然能收到外部消息,但单个会话会被阻塞,多个任务的上下文会混在一起,本地设备一离线就停止运行,仍然需要人来维护。
让 Agent 在后台持续工作的产品,最近几个月接连出现。xAI 8 月推出的 Grok Bot 可以让几个 Bot 待在同一个群聊里互相发消息、交接任务,Slack 或 GitHub 上有新消息就自动开始工作;Meta 9 月发布的 Muse 给每个用户分配一台专属云端虚拟机,关掉 App 后任务仍会继续运行,在 WhatsApp 里就能给它分配任务;OpenAI 9 月底推出的 dots 自带云电脑和浏览器,关闭聊天窗口后也会继续工作,可以在 Slack、Teams 里使用;Anthropic 10 月发布的 Claude Duet 面向职场人士和小企业,在自己的虚拟机里后台处理任务,需要用户批准时才会通知。DeepSeek 这次没有发布产品,发布的是一篇架构文章和一个开源原型,讲他们内部运行的 Super-agent 是怎么搭建的,并附了对照实验。文章开头还特意说明,这是面向工程实践的思路探讨,不是对 DeepSeek Harness 现有产品功能的介绍。
让主 Agent 自己分派任务可行吗
最直接的做法是只留一个会话,给它配一个 Subagent 工具,收到任务后由它判断是否交给子 Agent,子 Agent 在后台运行,主会话继续接收新消息。不少 Agent 工具支持这种做法,但是否委派由模型决定。
DeepSeek 的对照实验用群聊和 GitHub CI 消息流模拟工作环境,一次实验约 300 条消息,其中约 20 条是工作请求,其余是闲聊、跟进、叫停和 CI 通知。编码工作用一个只消耗时间的工具代替,所以衡量的是调度和协作,而不是写代码的能力;消息间隔和工作时长都按 1/4 缩放,模型调用耗时用的是真实值,每种方案运行 5 次。参与对比的有四种方案:Super-agent、去掉直通的 Super-agent,以及两种提示词下的单会话 + Subagent 工具。作者也说明,负载是合成的,环境做过简化,结果只作初步参考。
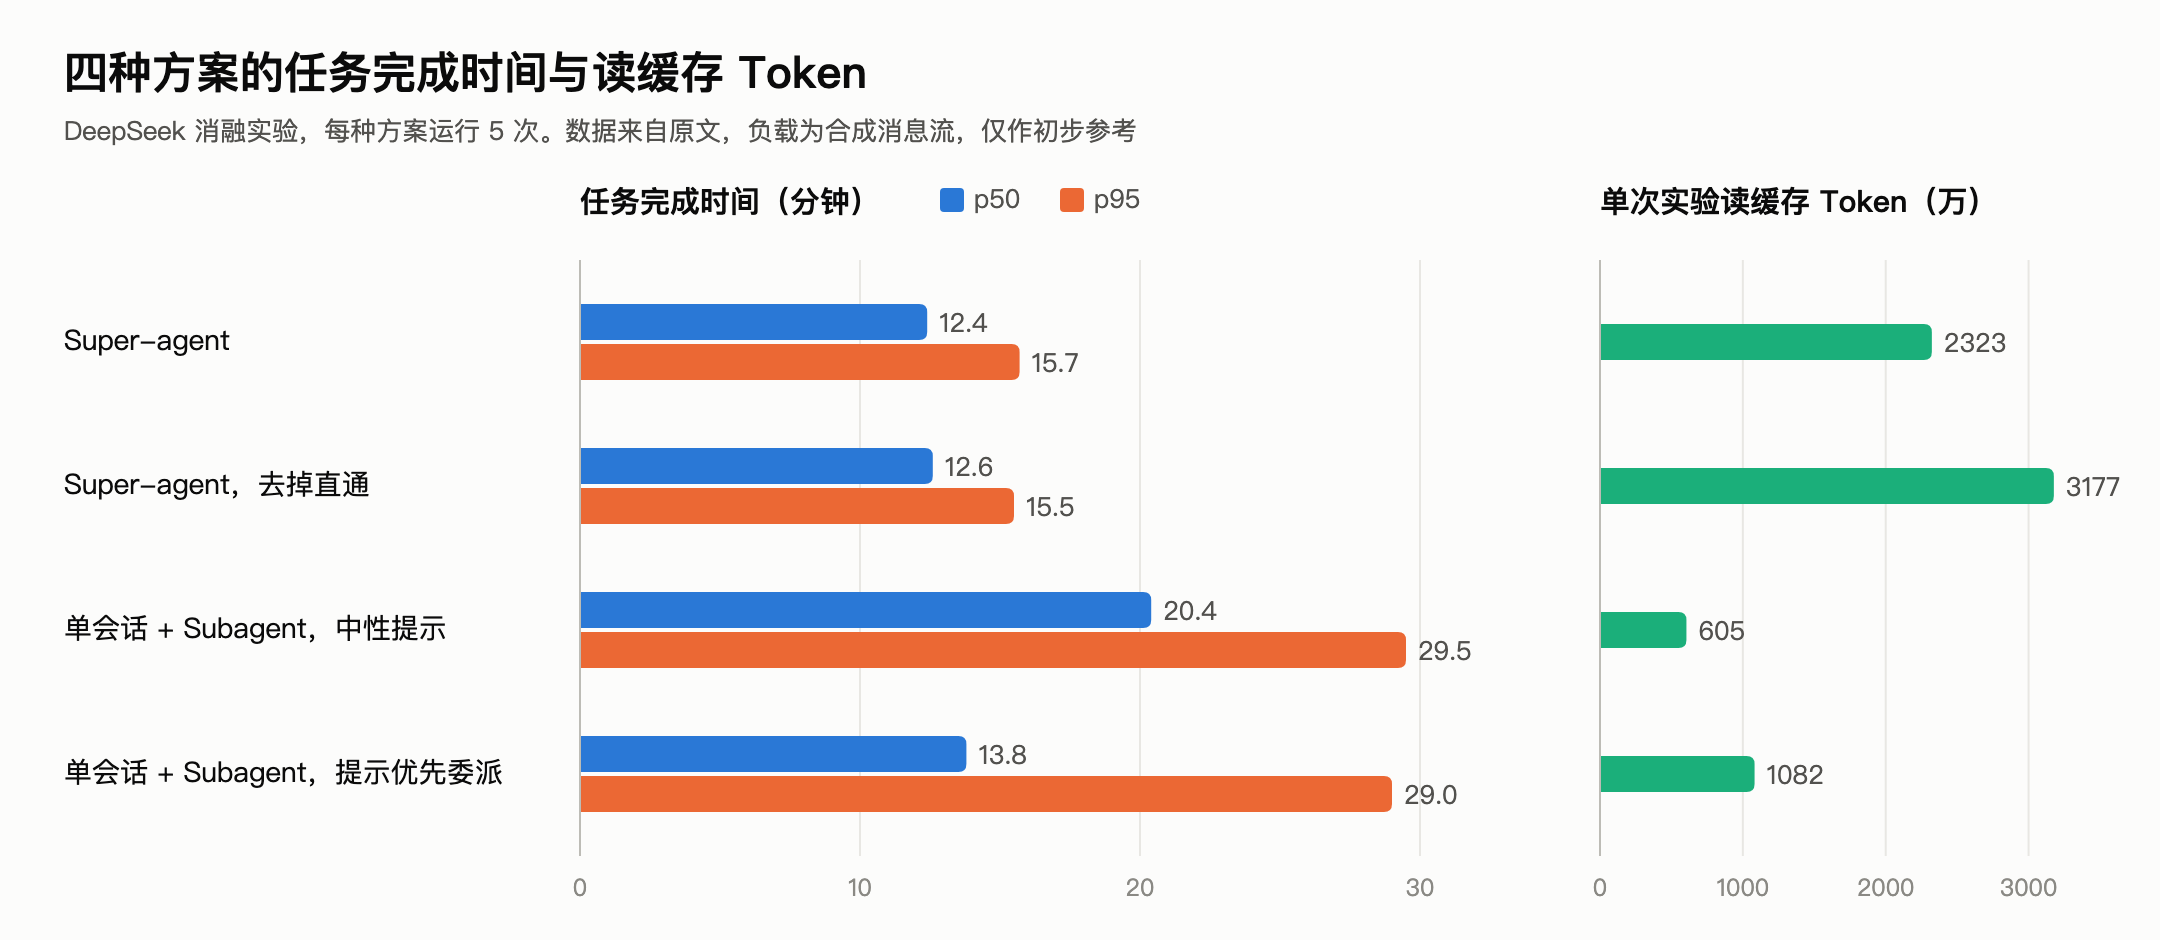
单会话方案试了两种提示词。中性提示写的是「Use a subagent for a piece of work when appropriate」,5 次运行里模型一次都没有调用 Subagent,所有工作都在主会话里完成,做到一半被新消息打断,回来继续做,然后又被打断,p95 到了 29.5 分钟。另一种提示把理由讲明白:群里每条消息都会发到主会话,自己执行任务就会不断被新消息打断,所以尽量把每项工作交给单独的 subagent,自己只处理小事。这一次 5 次里有 4 次委派了,中位数从 20.4 分钟降到 13.8 分钟;剩下那 1 次,模型判断这项工作「很小」,选择自己执行,p95 仍是 29 分钟,在完成曲线上拖出一条长尾。原文把问题归结为单会话方案依赖提示词和模型的临场判断来决定分不分工。
把分工写进架构
DeepSeek 的做法叫 Super-agent,核心是两层:
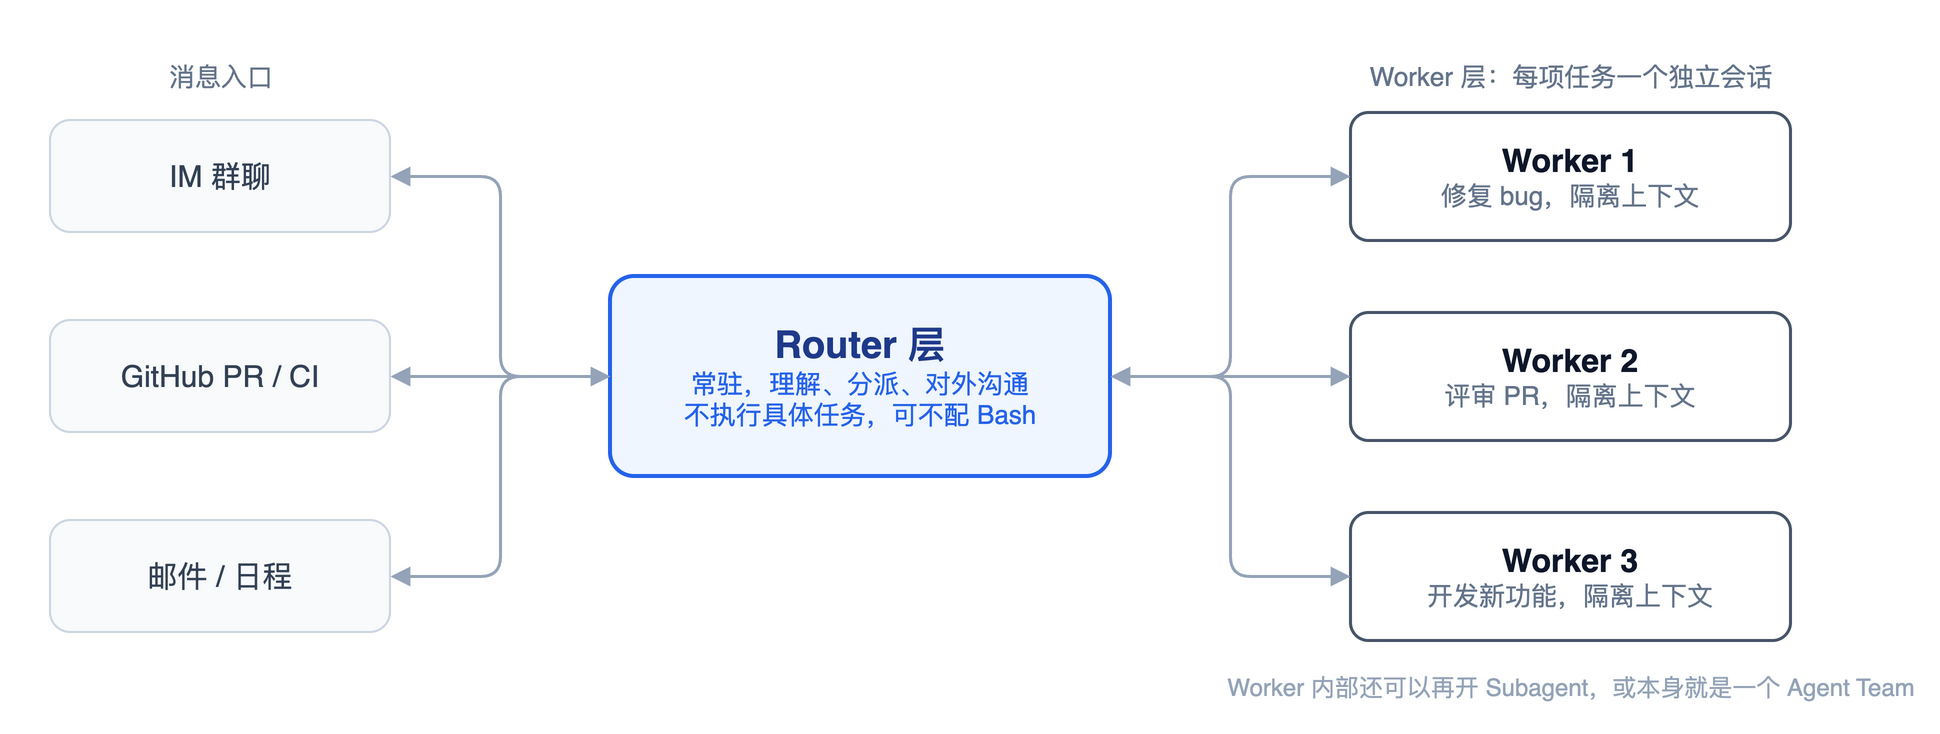
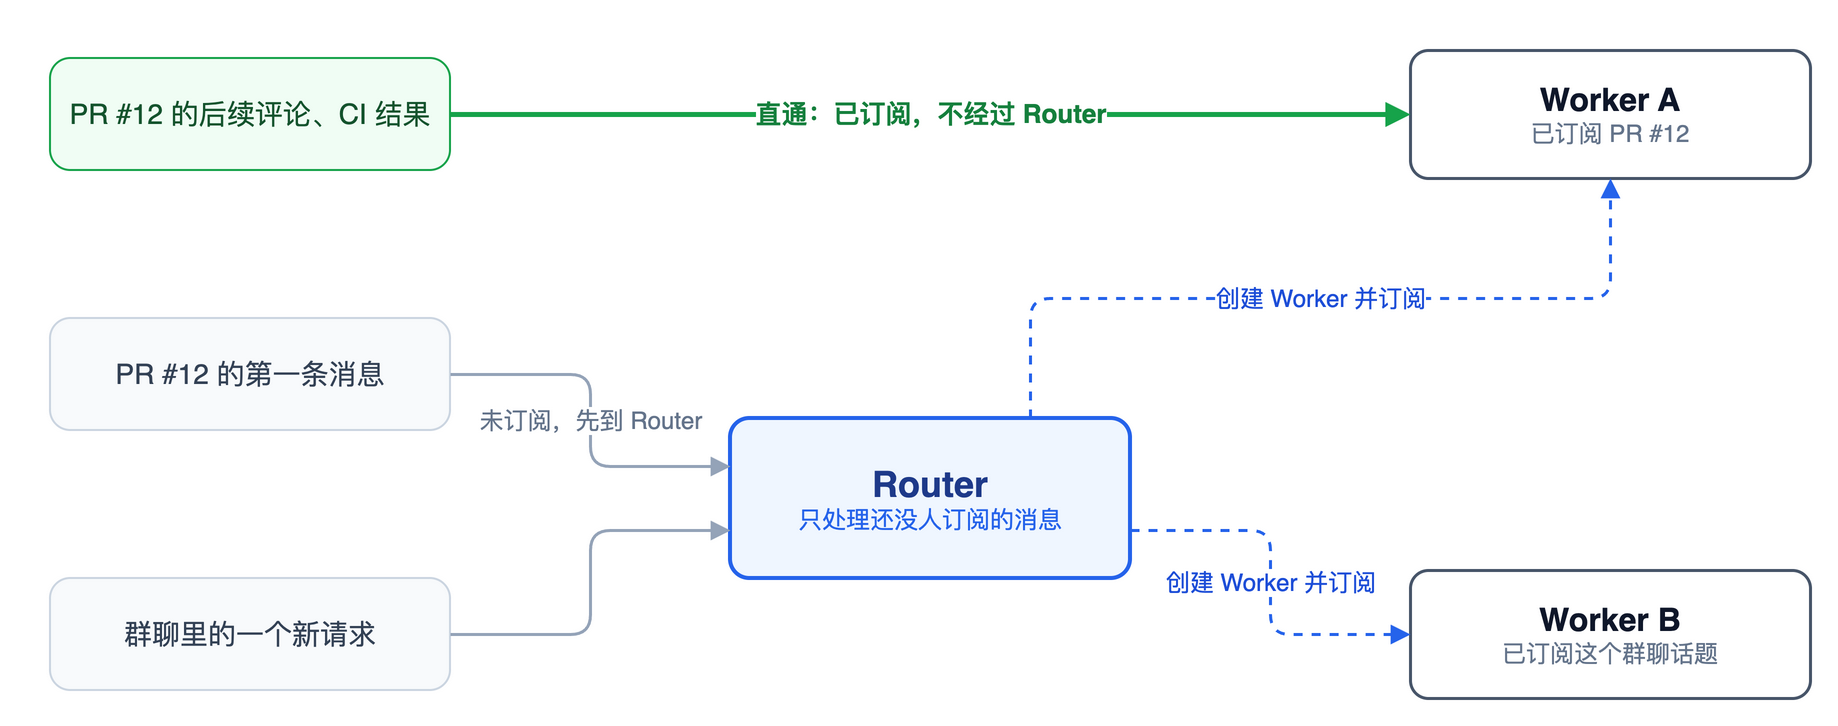
上面一层是常驻的 Router,所有入口的消息都先到这里,由它理解、分派,并负责跟人沟通。Router 在设计上不执行具体任务,甚至可以不配 Bash 工具,没有执行工具,它就只能把任务分派出去。这种一个中心节点分派多个执行节点的结构,看上去和常见的 Agent Team 相似,原文专门做了区分:Agent Team 多用于拆解单个复杂任务,子步骤耦合紧,Team Lead 要深入理解细节、高频协调各个成员,自己承担很重的推理;Router 只处理任务之间的关联和分派,不介入单个任务内部。按他们的实践,Router 的工作常常没有想象中复杂,用较轻量的模型就能兼顾速度和效果。
下面一层是 Worker。每项任务开一个独立会话来推进,冗长的推理和密集的工具调用都关在 Worker 里,不会出现在群聊里。Worker 之间一般也不直接通信,同一个 PR 上的冲突,靠各个 Worker 都订阅了这个 PR 的事件流各自发现;少数需要跨任务协调的,由 Router 中转。
还有一个细节叫「直通」。某个 Worker 接手一项任务后,就订阅该任务所在的话题,比如某个群聊话题或某个 PR,后续消息直接发送给它,不再经过 Router。这样做是为了给 Router 减负:已经分配出去的任务,如果每条后续消息还要由 Router 转发,Router 会承受大量负载,响应也会变慢。
同一组实验里,Super-agent 的中位数是 12.4 分钟,p95 是 15.7 分钟。在这组模拟实验中,p50 和 p95 相差 3.3 分钟,比单会话方案更接近。每种方案只跑了 5 次,结果还需要在更多场景里验证。
代价是 Token
这张图也说明,稳定性是有代价的。Super-agent 单次实验读缓存 2323 万 Token,单会话方案为 605 万到 1082 万,约为后者的 2.1 到 3.8 倍。多个会话各自维护上下文,会增加缓存读取量;实际费用还要看其他 Token 用量和模型计价。
直通能省一部分 Token,去掉直通的那组对照可以看出来:完成时间基本没变,但 Router 要做的决定多了约 30%,读缓存 Token 从 2323 万涨到 3177 万,增幅约 37%。原文的结论是,在实验负载下直通不提高任务完成的质量和速度,但给 Router 省下了可观的 Token 和推理开销。
他们还单独给 Router 做了压力测试:需要决定的消息到达速率从每分钟约 1 条提到约 40 条,平均每批合并的消息从 1.0 条升到 2.8 条,单次请求耗时只从 2.5 秒增加到 3.9 秒,摊到每个决定上的推理时间从 6.4 秒降到 1.6 秒。消息积压时,下一轮调用会把它们一起处理,所以即使去掉直通让 Router 负载上升,也没有碰到单个 Router 的吞吐上限。
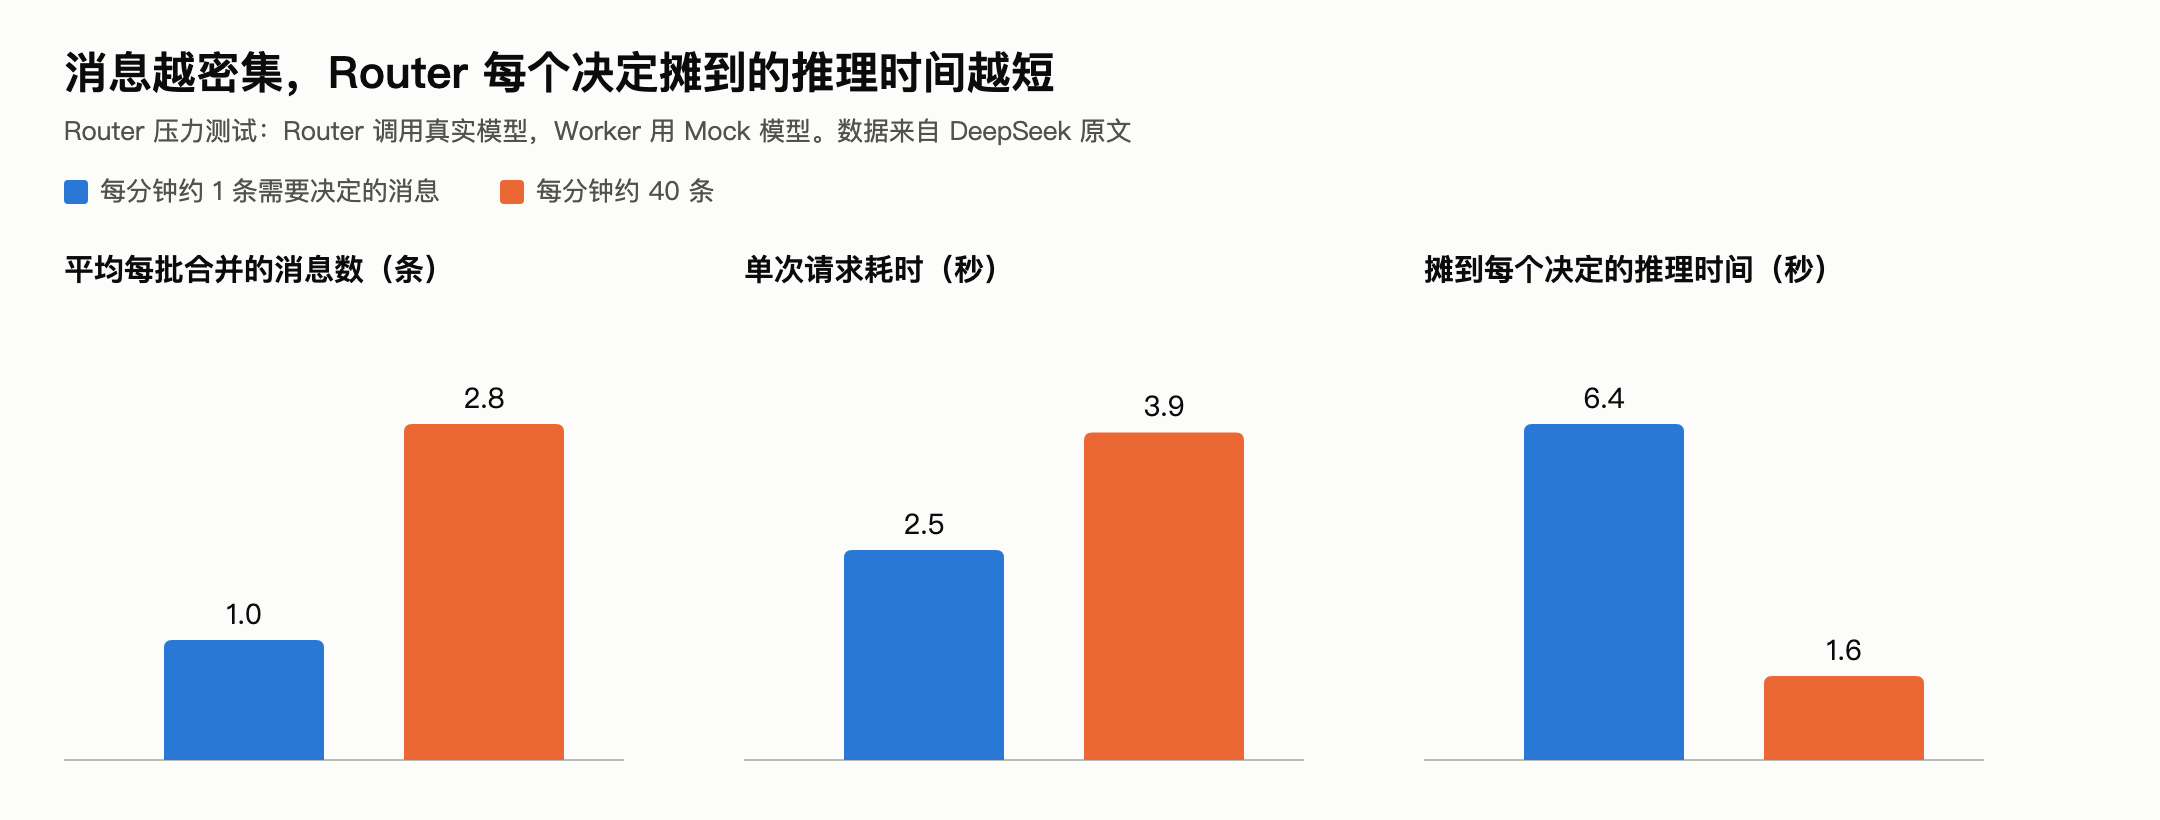
用更多 Token 换更短、更稳定的完成时间,原文自己也是这么概括的。值不值得,要看同时推进的任务有多少、等待一项任务的代价有多大,以及按实际模型计价算下来的费用。
多 Agent 的关键是谁来决定分工
Super-agent 内部其实也是多 Agent:一个 Worker 里还能再开 Subagent,本身也可以是一个 Agent Team,这些对 Router 都是透明的。它和「单会话 + Subagent 工具」的区别在于分工由谁决定。单会话方案里,每次是否把任务分派出去由模型临场判断;Super-agent 里,Router 没有执行工具,Worker 只接收自己订阅的话题的消息,分工在系统层面就定下来了。原文还提到,如果用提示词约束一个 Agent Team 的主会话不亲自执行任务,只负责对外交互和分派,它也可以看作这种双层架构。
对自己搭 Agent 系统的人,这一点可以直接借鉴:想让任务更稳定地并行推进,可以先试着收掉调度 Agent 的执行工具,让它只做分派。不过原文也承认,这套系统能以较低的复杂度运转,很大程度上靠的是当前阶段的工程和场景简化,比如只用一个常驻 Router 会话、Worker 之间不直接通信;任务规模扩大、耦合度变高之后,Router 什么时候需要水平切分、Worker 之间要不要直接通信,还没有定论。
参考
- Super-agent 设计探索:迈向更自主的 Agent 系统(DeepSeek,全文转载)
- Claude Duet app is Anthropic’s bet on agents(TechCrunch)
- Grok Bot Explained(DataCamp)
- Meta 的 Muse 不靠写代码赚钱,靠替你买东西
- OpenAI launches dots(TechCrunch)
关于
关注我获取更多资讯